Kecerdasan Buatan (AI) kini bukan lagi sekadar fiksi ilmiah. Dari rekomendasi film di Netflix, filter spam di email Anda, hingga mobil otonom yang bisa menyetir sendiri, semuanya digerakkan oleh teknologi bernama Machine Learning. Namun, tahukah Anda bahwa mesin tidak belajar dengan satu cara yang sama?
Secara garis besar, ada tiga metode utama yang digunakan mesin untuk belajar dari data. Memahami perbedaan supervised, unsupervised, dan reinforcement learning adalah langkah fundamental bagi siapa saja yang ingin mendalami dunia data science dan AI. Setiap metode memiliki pendekatan, jenis data, dan tujuan penyelesaian masalah yang sama sekali berbeda.
Bagi para pemula, istilah-istilah ini mungkin terdengar rumit dan teknis. Padahal, konsep dasarnya sangat lekat dengan cara manusia belajar sehari-hari. Jika Anda ingin tahu metode mana yang paling tepat untuk proyek bisnis atau riset Anda, Anda berada di tempat yang tepat.
Artikel ini akan mengupas tuntas setiap jenis machine learning secara mendalam. Kita akan membahas cara kerjanya, melihat contoh algoritma, dan menelusuri penerapan nyatanya di dunia industri. Mari kita mulai perjalanan memahami otak di balik kecerdasan buatan ini!
Apa Itu Machine Learning? Sebuah Pengantar Singkat
Sebelum membedah ketiga jenis pembelajaran mesin, kita perlu menyamakan pemahaman tentang apa itu machine learning. Singkatnya, machine learning adalah cabang dari kecerdasan buatan yang memungkinkan komputer belajar dari data. Alih-alih diprogram secara eksplisit dengan aturan (seperti “jika A, maka B”), sistem ini mencari pola sendiri.
Semakin banyak data yang dimasukkan, semakin pintar mesin tersebut dalam membuat prediksi atau keputusan. Ini mirip dengan cara anak kecil belajar mengenali benda. Anda tidak memberinya rumus matematis tentang bentuk kucing; Anda hanya menunjukkan banyak foto kucing sampai ia paham sendiri.
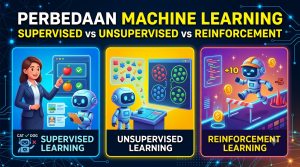
Dalam praktiknya, data yang tersedia di dunia nyata sangat bervariasi. Ada data yang sudah rapi dan memiliki label, ada pula data mentah yang berantakan. Perbedaan jenis data dan tujuan akhir inilah yang melahirkan tiga aliran utama: Supervised Learning, Unsupervised Learning, dan Reinforcement Learning.
1. Supervised Learning: Belajar dengan Bimbingan Guru
Supervised learning (pembelajaran terarah) adalah jenis machine learning yang paling umum dan banyak digunakan saat ini. Sesuai namanya, algoritma ini belajar di bawah “pengawasan” atau bimbingan. Bimbingan ini hadir dalam bentuk data berlabel (labeled data).
Artinya, setiap data yang dimasukkan ke dalam model sudah memiliki pasangan input dan output yang benar. Mesin bertugas mencari hubungan matematis atau pola antara input dan output tersebut. Tujuannya adalah agar mesin bisa memprediksi output dengan akurat ketika diberikan data baru yang belum pernah ia lihat sebelumnya.
Bayangkan Anda mengajari seorang anak membedakan apel dan jeruk. Anda menunjukkan buah apel dan berkata, “Ini apel” (memberikan label). Lalu Anda menunjukkan jeruk dan berkata, “Ini jeruk”. Setelah beberapa kali, anak tersebut bisa menebak buah baru dengan benar. Itulah inti dari supervised learning.
Cara Kerja Algoritma Supervised Learning
Proses kerja algoritma supervised learning sangat terstruktur. Pertama, Anda harus mengumpulkan dataset yang berisi fitur (input) dan target (output/label). Misalnya, dataset harga rumah berisi luas tanah, jumlah kamar, dan lokasi (fitur), serta harga jual aslinya (target).
Kedua, Anda membagi data tersebut menjadi data latih (training data) dan data uji (testing data). Mesin akan mempelajari data latih untuk membangun model matematis. Selama proses pelatihan, mesin akan terus menebak output dan membandingkannya dengan label yang benar.
Ketiga, jika tebakan mesin salah, ia akan menyesuaikan perhitungannya secara otomatis untuk meminimalkan tingkat kesalahan. Proses ini berulang hingga model mencapai tingkat akurasi yang diinginkan. Terakhir, model akan dievaluasi menggunakan data uji untuk memastikan ia tidak hanya menghafal, tetapi benar-benar memahami polanya.
Kategori dan Contoh Algoritma Supervised Learning
Secara umum, supervised learning terbagi menjadi dua kategori utama berdasarkan jenis output yang dihasilkan:
-
Klasifikasi (Classification): Digunakan jika outputnya berupa kategori diskrit atau kelas. Misalnya: membedakan email spam atau bukan spam, memprediksi apakah pasien sakit atau sehat.
-
Regresi (Regression): Digunakan jika outputnya berupa nilai angka kontinu (berkelanjutan). Misalnya: memprediksi harga saham esok hari, atau memperkirakan suhu udara.
Beberapa contoh algoritma yang populer di kategori ini meliputi:
-
Linear Regression: Algoritma dasar untuk memprediksi nilai angka berdasarkan hubungan linier antar variabel.
-
Logistic Regression: Algoritma populer untuk masalah klasifikasi biner (dua pilihan).
-
Support Vector Machine (SVM): Sangat tangguh untuk memisahkan data klasifikasi yang kompleks.
-
Random Forest: Kumpulan dari banyak decision tree (pohon keputusan) untuk menghasilkan prediksi yang sangat akurat.
Penerapan Supervised Learning di Dunia Nyata
Dalam dunia bisnis, supervised learning adalah tulang punggung otomasi. Bank menggunakannya untuk mendeteksi penipuan kartu kredit (klasifikasi transaksi normal vs curang). Mereka menganalisis ribuan data transaksi berlabel di masa lalu untuk mengenali pola penipuan.
Di bidang kesehatan, dokter menggunakan model regresi untuk memprediksi perkembangan penyakit pasien berdasarkan rekam medis. Sementara itu, platform media sosial menggunakan klasifikasi gambar untuk mengenali wajah Anda dan teman-teman Anda secara otomatis saat mengunggah foto.
2. Unsupervised Learning: Menemukan Pola Tersembunyi Tanpa Label
Jika supervised learning membutuhkan data berlabel, unsupervised learning justru sebaliknya. Algoritma ini dilepas untuk mengolah data yang tidak berlabel (unlabeled data). Tidak ada “guru” yang memberitahu mesin apa output yang benar.
Tugas utama dari algoritma ini adalah mengeksplorasi data mentah dan menemukan struktur, pola, atau anomali tersembunyi di dalamnya secara mandiri. Pendekatan ini sangat berguna ketika kita memiliki kumpulan data yang masif tetapi tidak memiliki waktu atau sumber daya untuk melabelinya satu per satu.
Analogi yang tepat untuk jenis ini adalah seorang detektif yang menyusun puzzle tanpa melihat gambar di kotak kemasannya. Sang detektif harus mengelompokkan potongan puzzle berdasarkan warna, tekstur, atau bentuk tepiannya hingga membentuk sebuah pola yang masuk akal.
Cara Kerja Algoritma Unsupervised Learning
Karena tidak ada output yang dijadikan acuan, mesin menggunakan metode statistik untuk mencari kesamaan atau perbedaan antar data. Algoritma akan memindai seluruh dataset dan mengekstrak fitur-fitur penting secara matematis.
Setelah itu, mesin mulai mengelompokkan data yang memiliki karakteristik mirip ke dalam satu kelompok (cluster). Data yang berada di kelompok yang sama memiliki kedekatan jarak matematis, sedangkan data di kelompok berbeda memiliki jarak yang jauh.
Proses ini berjalan sepenuhnya otomatis tanpa campur tangan manusia. Manusia baru berperan di akhir proses untuk menafsirkan arti dari kelompok-kelompok yang berhasil dibentuk oleh mesin tersebut.
Kategori dan Contoh Algoritma Unsupervised Learning
Algoritma ini memiliki fungsi yang unik dan biasanya dibagi menjadi tiga kategori utama:
-
Clustering (Pengelompokan): Membagi data ke dalam kelompok-kelompok berdasarkan kemiripan.
-
Association Rule (Aturan Asosiasi): Menemukan hubungan atau aturan sebab-akibat antar variabel dalam database berskala besar.
-
Dimensionality Reduction (Pengurangan Dimensi): Menyederhanakan data yang terlalu kompleks (memiliki banyak fitur) tanpa menghilangkan informasi penting di dalamnya.
Contoh algoritma unsupervised learning yang sering dipakai data scientist adalah:
-
K-Means Clustering: Membagi data menjadi sejumlah K kelompok berdasarkan nilai rata-rata (centroid) terdekat.
-
Apriori: Algoritma klasik untuk mencari asosiasi antar produk (sering digunakan dalam analisis keranjang belanja).
-
Principal Component Analysis (PCA): Teknik ampuh untuk mengurangi dimensi data agar lebih cepat diproses tanpa merusak kualitas informasi.
Penerapan Unsupervised Learning di Dunia Nyata
Unsupervised learning sangat mendominasi dunia marketing dan e-commerce. Perusahaan seperti Amazon menggunakan clustering untuk melakukan segmentasi pelanggan. Mereka mengelompokkan pembeli berdasarkan kebiasaan belanja, lalu merancang promosi yang spesifik untuk setiap kelompok.
Algoritma asosiasi digunakan oleh Netflix dan YouTube untuk sistem rekomendasi (“Orang yang menonton film A, biasanya juga menonton film B”). Di bidang keamanan siber, metode ini dipakai untuk anomaly detection (mendeteksi anomali), di mana sistem akan membunyikan alarm jika ada aktivitas jaringan yang polanya melenceng dari kebiasaan normal.
3. Reinforcement Learning: Belajar dari Pengalaman (Trial and Error)
Reinforcement Learning adalah pendekatan yang paling berbeda sekaligus paling mendekati kecerdasan manusia yang sesungguhnya. Di sini, mesin (yang disebut sebagai Agen) belajar berinteraksi dengan sebuah Lingkungan (Environment).
Agen ini tidak diberi data berlabel, tidak juga disuruh mencari pola statis. Sebaliknya, agen dibiarkan mengambil tindakan (Action) sendiri. Setiap tindakan yang diambil akan menghasilkan konsekuensi berupa Hadiah (Reward) jika benar, atau Hukuman (Penalty) jika salah.
Tujuan utama agen adalah memaksimalkan total hadiah yang ia kumpulkan seiring berjalannya waktu. Ia belajar sepenuhnya melalui metode coba-coba (trial and error). Konsep ini mengadaptasi ilmu psikologi perilaku (behavioral psychology) ke dalam ilmu komputer.
Anda bisa membayangkan proses ini seperti melatih anjing peliharaan peliharaan Anda. Jika anjing berhasil duduk saat diperintah, Anda memberinya camilan (reward). Jika ia malah melompat, Anda tidak memberinya apa-apa (penalty). Lama-kelamaan, anjing tersebut akan selalu duduk agar mendapat camilan.
Cara Kerja Algoritma Reinforcement Learning
Proses kerjanya merupakan sebuah siklus yang terus berulang (simulasi). Agen pertama-tama akan mengamati kondisi atau state dari lingkungan saat ini. Berdasarkan pengamatan tersebut, agen memutuskan untuk melakukan suatu tindakan tertentu.
Tindakan itu akan mengubah kondisi lingkungan. Lingkungan kemudian merespons dengan memberikan feedback (umpan balik) berupa poin reward atau penalty kepada agen. Sistem mencatat kombinasi state-action-reward ini ke dalam sebuah memori pembelajaran.
Agen akan mengulangi simulasi ini ribuan hingga jutaan kali. Di awal-awal, agen mungkin akan melakukan banyak tindakan bodoh secara acak (fase eksplorasi). Namun seiring berjalannya waktu, ia akan menemukan strategi terbaik (policy) untuk selalu memenangkan hadiah maksimal (fase eksploitasi).
Contoh Algoritma Reinforcement Learning
Algoritma dalam kategori ini berfokus pada optimasi keputusan beruntun. Beberapa yang paling terkenal adalah:
-
Q-Learning: Algoritma model-free yang menggunakan tabel nilai Q untuk memandu agen mengambil tindakan terbaik di setiap situasi.
-
Deep Q-Network (DQN): Menggabungkan Q-Learning dengan Deep Learning (jaringan saraf tiruan) agar bisa menyelesaikan masalah yang ruang lingkupnya sangat luas, seperti bermain video game.
-
Policy Gradient Methods: Algoritma yang langsung mengoptimalkan strategi tanpa harus menghitung nilai dari setiap tindakan secara spesifik.
Penerapan Reinforcement Learning di Dunia Nyata
Puncak ketenaran reinforcement learning terjadi ketika AlphaGo (AI buatan Google DeepMind) mengalahkan juara dunia permainan papan Go. AI tersebut berlatih dengan cara bermain melawan dirinya sendiri jutaan kali hingga menemukan strategi yang tak pernah dipikirkan manusia.
Saat ini, implementasinya banyak ditemukan di bidang robotika industri. Lengan robot di pabrik belajar cara mengambil barang dengan berbagai bentuk melalui simulasi trial and error. Selain itu, sistem navigasi pada mobil self-driving (otonom) menggunakan reinforcement learning untuk belajar mengerem, menghindar, atau berakselerasi dengan aman di jalan raya yang padat.
Tabel Perbandingan: Supervised vs Unsupervised vs Reinforcement Learning
Untuk mempermudah pemahaman Anda, mari kita rangkum perbedaan supervised, unsupervised, dan reinforcement learning ke dalam tabel komparasi berikut ini.
| Kriteria | Supervised Learning | Unsupervised Learning | Reinforcement Learning |
| Jenis Data | Memiliki label (Labeled data) | Tidak berlabel (Unlabeled data) | Tidak butuh data awal, belajar dari interaksi |
| Cara Belajar | Dipandu oleh output/jawaban yang sudah diketahui | Mandiri mencari pola dan struktur tersembunyi | Trial and Error (Coba-coba) dengan umpan balik |
| Umpan Balik | Langsung (membandingkan prediksi dengan label asli) | Tidak ada umpan balik yang pasti | Poin Reward (Hadiah) atau Penalty (Hukuman) |
| Tujuan Utama | Memprediksi masa depan berdasarkan data masa lalu | Menemukan struktur dan segmentasi data yang kompleks | Belajar mengambil rangkaian keputusan terbaik |
| Contoh Kasus | Prediksi harga rumah, klasifikasi gambar, filter spam | Segmentasi pelanggan, sistem rekomendasi produk | Robotika, bermain game AI, mobil otonom |
| Kompleksitas | Relatif paling sederhana, namun butuh biaya pelabelan | Lebih kompleks, hasil butuh interpretasi manusia | Sangat kompleks, butuh daya komputasi raksasa |
Kapan Harus Menggunakan Masing-masing Pendekatan?
Menentukan jenis machine learning yang tepat bergantung sepenuhnya pada dua hal: data yang Anda miliki dan masalah yang ingin Anda pecahkan. Tidak ada algoritma yang lebih superior; semuanya unggul di medannya masing-masing.
Gunakan Supervised Learning jika Anda sudah memiliki data historis yang rapi dan Anda tahu persis apa yang ingin Anda prediksi. Pendekatan ini sangat sempurna untuk peramalan (forecasting), mendiagnosis penyakit medis, atau mengotomatisasi penyortiran dokumen.
Pilihlah Unsupervised Learning jika Anda memiliki gunungan data mentah dan Anda sendiri tidak tahu insight apa yang ada di dalamnya. Ini adalah senjata utama para analis data untuk menemukan audiens target baru, mendeteksi kecurangan keuangan yang polanya tidak tertebak, atau mengelompokkan gen dalam riset biologi.
Terapkan Reinforcement Learning jika masalah Anda tidak melibatkan data tabular, melainkan melibatkan pengambilan keputusan beruntun dalam lingkungan yang dinamis. Ini adalah pilihan mutlak jika Anda sedang mengembangkan game AI, mengoptimalkan rute logistik real-time, atau membangun robot yang bisa beradaptasi dengan lingkungan baru.
Masa Depan Ketiga Jenis Machine Learning
Dunia kecerdasan buatan berkembang dengan kecepatan eksponensial. Batas antara perbedaan supervised, unsupervised, dan reinforcement learning kini perlahan mulai memudar seiring munculnya teknik-teknik hybrid baru. Salah satu yang paling fenomenal adalah Semi-supervised Learning.
Metode ini menggabungkan sedikit data berlabel dengan jumlah data tanpa label yang sangat besar. Cara ini secara dramatis memotong biaya dan waktu pelabelan data secara manual, namun tetap menghasilkan prediksi yang sama akuratnya dengan supervised learning murni.
Selain itu, tren saat ini mengarah pada Self-supervised learning, fondasi di balik Large Language Models (LLM) raksasa seperti ChatGPT. Mesin secara otomatis menyembunyikan sebagian kalimat dan mencoba menebak kata yang hilang, pada dasarnya membuat “label” sendiri dari data teks yang tidak berlabel di internet. Di masa depan, integrasi berbagai jenis machine learning ini akan menghasilkan sistem AI yang semakin mandiri dan meniru kognisi manusia secara utuh.
FAQ (Pertanyaan yang Sering Diajukan)
1. Apakah saya harus mahir matematika untuk mempelajari ketiganya?
Pemahaman dasar tentang statistik, kalkulus, dan aljabar linier sangat dianjurkan. Namun saat ini, sudah banyak library Python (seperti Scikit-Learn dan TensorFlow) yang menyederhanakan perhitungan matematis tersebut, sehingga Anda bisa lebih fokus pada logika penyelesaian masalah.
2. Di antara ketiganya, mana yang paling sering dipakai di perusahaan?
Supervised learning masih menjadi raja di dunia industri saat ini. Alasannya sederhana: algoritma ini lebih mudah diimplementasikan, hasilnya mudah diukur, dan secara langsung menjawab kebutuhan bisnis spesifik seperti memprediksi churn pelanggan atau estimasi penjualan bulanan.
3. Mengapa pelabelan data di Supervised Learning dianggap mahal?
Karena pelabelan seringkali harus dilakukan secara manual oleh manusia (human in the loop). Misalnya, untuk melatih AI mengenali sel kanker, seorang dokter spesialis harus melihat puluhan ribu gambar X-Ray dan menandai area kanker secara manual. Ini memakan waktu dan biaya pakar yang sangat tinggi.
4. Bisakah satu proyek menggunakan lebih dari satu jenis Machine Learning?
Sangat bisa. Proses ini sering disebut sebagai pipeline model. Misalnya, sebuah bank mungkin menggunakan Unsupervised Learning (clustering) terlebih dahulu untuk mengidentifikasi kelompok nasabah berisiko. Setelah label risiko itu terbentuk, mereka menggunakan Supervised Learning untuk memprediksi risiko pada nasabah baru di masa depan.
5. Apa kelemahan utama Reinforcement Learning?
Kelemahan utamanya adalah kebutuhannya akan ribuan hingga jutaan percobaan (simulasi) sebelum agen bisa mempelajari sesuatu yang berguna. Proses ini membutuhkan daya komputasi komputer yang sangat masif dan memakan waktu lama, serta sulit diterapkan langsung ke dunia nyata karena risiko keselamatan (misal: melatih mobil otonom langsung di jalan raya sangat berbahaya).
6. Apakah Machine Learning sama dengan Deep Learning?
Tidak sama, namun berkaitan erat. Deep learning adalah sub-bidang dari machine learning yang khusus menggunakan struktur Jaringan Saraf Tiruan (Artificial Neural Networks) berlapis-lapis. Deep learning dapat diaplikasikan untuk supervised, unsupervised, maupun reinforcement learning.
Kesimpulan
Memahami perbedaan supervised, unsupervised, dan reinforcement learning adalah pondasi paling krusial sebelum Anda terjun ke proyek Artificial Intelligence. Ketiganya menawarkan paradigma berpikir yang sama sekali berbeda dalam memecahkan masalah.
Supervised learning bertindak sebagai murid yang taat dan mahir menebak masa depan berdasarkan panduan masa lalu. Unsupervised learning adalah sang detektif cemerlang yang mampu mengungkap struktur rahasia dari tumpukan data yang acak. Sementara Reinforcement learning adalah petualang tangguh yang terus menyempurnakan keahliannya melalui rentetan kegagalan dan keberhasilan.
Apapun masalah bisnis atau riset yang Anda hadapi, selalu ada satu algoritma machine learning yang paling cocok untuk menyelesaikannya. Kuncinya terletak pada kemampuan Anda mendefinisikan ketersediaan data dan tujuan akhir dari proyek tersebut.
Jangan biarkan data perusahaan Anda tertidur tanpa guna. Mulailah eksplorasi data Anda hari ini, pelajari pola pelanggan Anda, dan jadilah yang terdepan di era transformasi digital. Jika Anda merasa artikel ini bermanfaat, bagikan wawasan ini ke rekan kerja Anda atau tinggalkan pertanyaan di kolom komentar agar kita bisa berdiskusi lebih lanjut!